
広告コピーのA案とB案、最終的に「なんとなくこっち」で決まっていませんか。
電通がこの1年かけて取り組んでいたのは、その「なんとなく」を11万件の評価データに変換する研究でした。
しかも研究がうまくいかなかった部分こそ、中小企業には好都合なんですよね。
電通が1年かけて作ったのは、AIではなく何か。
2026年9月1日、電通・電通デジタル・SB Intuitionsの3社が共同研究の成果を公表しました。
研究の開始は2025年9月25日なので、ほぼ1年かけたプロジェクトです。
成果物の中身がこれです。
電通に所属するコピーライター64名が共通の基準でコピーを評価し、計116,532件の評価データを構築しました。
「ファースト・インパクト」「インサイトの深さ」「言葉選びの妥当性」などの評価観点を整理したうえで、その判定を人間が11万回繰り返したわけですね。
使ったAIは、SB Intuitionsが開発する国産生成AI「Sarashina」。
手法名はLLM-as-a-Judge、AIに採点役をやらせる評価手法で、FIT2026で発表される論文のタイトルにもそのまま入っています。
ここが読み飛ばされがちなポイントです。
モデルをゼロから作ったわけではなく、既にあるSarashinaを活用しています。
1年と64名を投じた先は、モデルそのものではなく評価基準とデータの側なんですよね。
11万件の評価データは、中小企業に作れるのか。
作れません。
64名のコピーライターを1年拘束できる会社はほぼないですし、11万件を64人で割ると1人あたり1,800件超です。
片手間で終わる量ではないですね。
「やっぱり大手の話か」って思いますよね。
ただ、なぜ11万件も必要だったのかを考えると話が変わってきます。
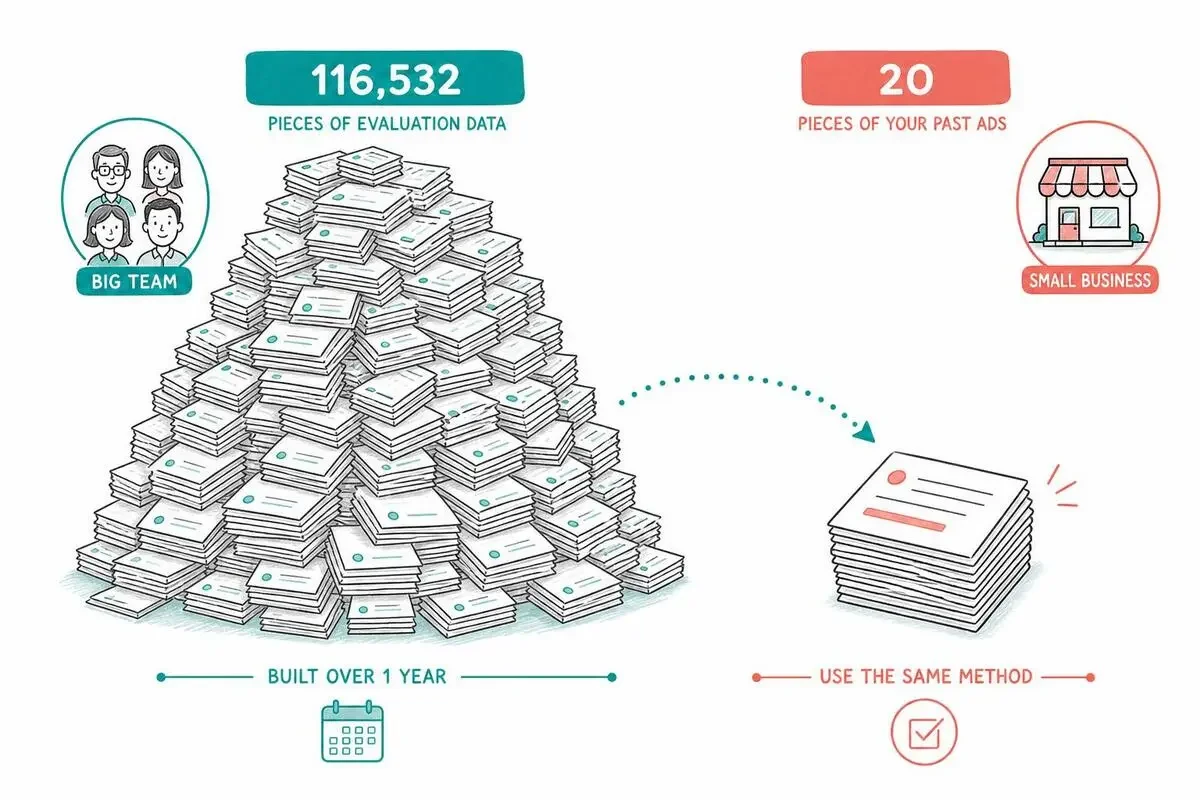
3社が狙っているのは「日本語コピーライティング特化型生成AI」の実用化で、リリースにも「幅広い分野への適用」という言葉が出てきます。
化粧品でも工作機械でも不動産でも通用する基準を1本で作ろうとすれば、データは当然それだけ要りますよね。
11万件という数字は、汎用性の値札なんです。
自社の1業種分だけでいいなら、必要な量は桁が変わります。
電通がつまずいた場所が、中小企業の強みになる理由。
プレスリリースには、都合の悪い結果もはっきり書かれています。
学習・最適化を行った業種・商材では、AIの評価とコピーライターの評価に一定程度の正の相関が確認された。
一方で未学習の業種・商材では相関が低下し、プロンプト調整のみでは幅広い分野への適用が難しいと。
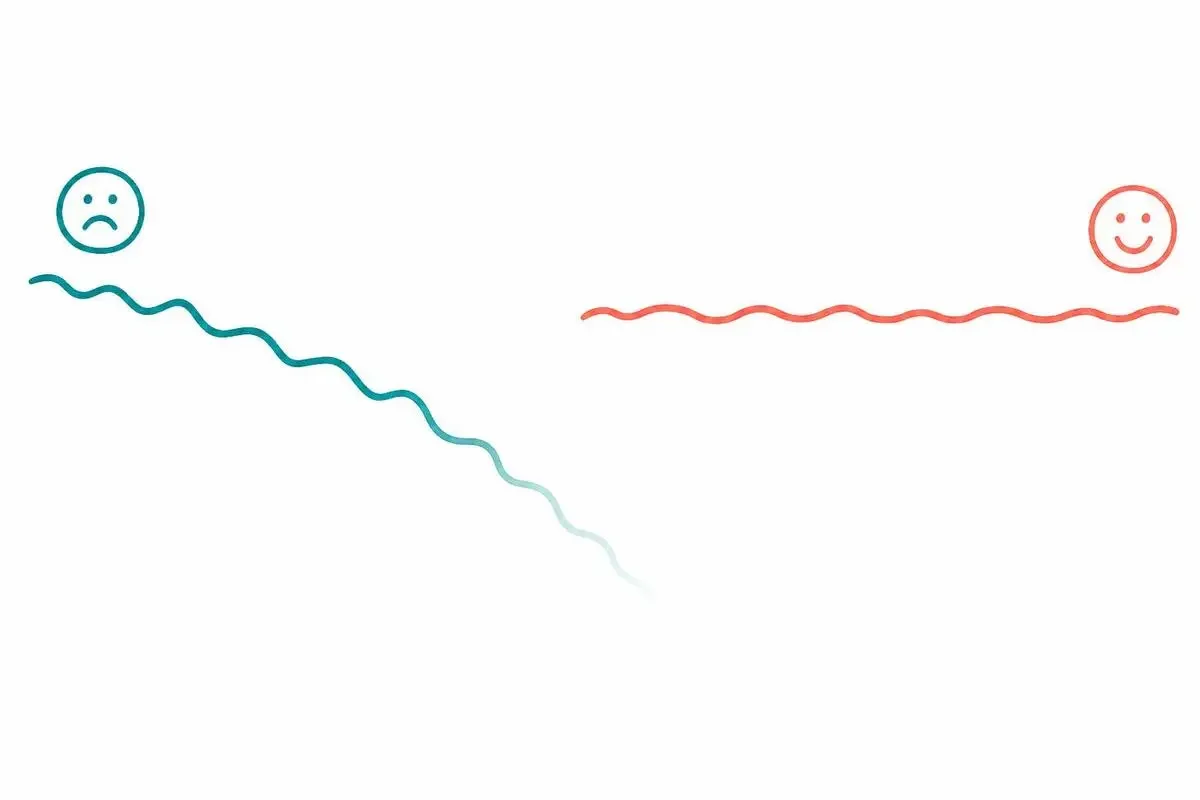
研究としては正直な報告ですが、裏返すと「業種を絞れば効く」と言っているのと同じです。
個人的にはここが一番アツいポイントで、中小企業が持っている条件とぴったり噛み合うんですよね。
自社の業種は1つ。
商材は数えられる範囲。
顧客層もだいたい1つです。
汎用化という一番高い壁を、そもそも登る必要がない。
64名と11万件は、登らなくていい壁の通行料でした。
自社の過去コピーを、何本どう選ぶか。
自社専用の採点AIを作る材料は、過去コピーと実績数字だけです。
本数は20本前後で足ります。
勝ち10本、負け10本。
「勝ち」を感覚で決めると、ここで全部崩れます。
リスティングならCTRとCVR、SNSならプロフィールクリックと保存数、メルマガなら開封率。
媒体ごとに指標を1つ決めて、数字の上位と下位を抜き出します。
負け側を捨てないのが肝心です。
電通も64名に「共通の基準で評価」させています。
評価というのは差を付ける作業なので、スコアに幅のあるデータが必要なんですよね。
勝ちコピーだけ並べてAIに渡すと、全部まとめて「良いコピーです」と返ってきます。
差分がないので当然ですね。
渡し方は、1本ずつではなく20本まとめて、数字を付けたまま投げます。
そのうえで基準を自分で書かずに、AIに書かせます。
以下は同じ商材の広告コピー20本と、それぞれの実績数値です。
上位10本と下位10本を分ける要因を、評価基準の形で言語化してください。
抽象的な形容詞は使わず、第三者が同じ判定を再現できる条件で書いてください。
使うAIはChatGPTでもClaudeでも構いません。
電通のようにモデル側を作り込む話ではないので、手元で普段使っているもので十分です。
自分で基準を書くと、どうしても自分の好みが混ざります。
数字とコピーだけ渡して要因を推定させたほうが、自社の顧客が実際に反応しているポイントが出てきますね。
電通の評価観点を、自社の言葉にどう翻案するか。
公表されたのは「ファースト・インパクト」「インサイトの深さ」「言葉選びの妥当性」の3つです。
リリースの表記は「など」付きなので、実際にはもっとあって非公開と読むのが自然ですね。
公開されている分を自社向けに置き換えると、こうなります。
- ファースト・インパクト: タイムラインを親指で流される0.5秒で止まるか。判定条件まで落とすと「冒頭に数字が入っている」「自社名より顧客の悩みが先に来ている」など、自社の勝ちコピーに共通している形式的な特徴になります。
- インサイトの深さ: 顧客が自分ではまだ言葉にできていない不満を当てているか。素材は問い合わせフォームの自由記述とレビュー本文です。顧客が実際に使った表現をそのまま基準に書き写します。
- 言葉選びの妥当性: 業界用語との距離感です。BtoBでは専門用語が信頼の証になりますが、一般消費者向けだと同じ単語が壁になります。自社がどちら側なのかを明記しないと、採点がブレます。
翻案で失敗するのは、抽象語のまま渡したときです。
「ファースト・インパクトが高いか採点して」だけだと、同じコピーを投げ直すだけでスコアが動きます。
観点名の下に、自社の判定条件を1行か2行足す。
これだけで採点の再現性がかなり上がります。
この基準が効かなくなるのはいつか。
答えは電通の検証結果にそのまま書いてあります。
業種・商材が変われば相関は落ちる。
自社側でも、新商材を出した、ターゲットの年齢層を変えた、主戦場の媒体を移した、このどれかが起きた時点で基準は作り直しです。
一度作った評価基準は資産になりますが、永久資産ではないんですよね。
成果データが溜まったら勝ち負けの20本を入れ替えて、基準も更新する。
四半期に1回くらいの頻度で足ります。
最初の一歩は、勝ちコピー10本と負けコピー10本を数字付きで1枚に並べるところまで。
ここだけなら30分で終わります。
AIに採点させるのはその後でいいので、まずは自社の数字を並べてみてください。
- 2
- 0
元広告代理店マーケター。月数千万の広告費を回していた経験を持ちながら、SEO×SNSのオーガニック戦略に特化。AIを活用したキーワード調査・コンテンツ企画・SNS運用分析で、広告費ゼロでも集客できることを証明し続けています。


創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
クロージング師匠
- 2
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
 AI集客@ルイ
- 3
- 0
-
 さくら
- 4
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
AI経営者の参謀@ひで
- 4
- 0
-
- 1
- 0
-
さくら
- 4
- 0
-
カイ@プロダクトマネージャー
- 5
- 0
-
- 3
- 0
-
さくら
- 4
- 0
-
 たいが
- 5
- 0
-
 リョウ
- 6
- 0
-
- 5
- 0
-
 まさき
- 5
- 0
-
AI経営者の参謀@ひで
- 3
- 0
-
 gen
- 5
- 0
-
- 2
- 0
-
AI経営者の参謀@ひで
- 4
- 0
-
AI経営者の参謀@ひで
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます