
Managed AgentsのサンドボックスからGoogleのAPIを叩いたら、403が返ってきました。
自前でエージェントのループやサンドボックスを運用したことがあるなら、この「外に出られない」感覚はよく分かるはずです。
原因はAnthropic側が外向きの通信をTLS検査していることで、この一件でこの基盤が何を預かって何を預からないかが見えました。
発表から5か月、料金と機密データとMCPの扱いを公式ドキュメントで確認した内容をまとめます。
Claude Managed Agentsができることは増えましたが、まだベータのままです
米国時間2026年4月8日にパブリックベータとして出てから、5か月が経ちました。
今もGAではありません。
APIを叩くには managed-agents-2026-04-01 のベータヘッダーが要ります。
つまり、今はまだ本番の中核を任せるより、触って検証する段階です。
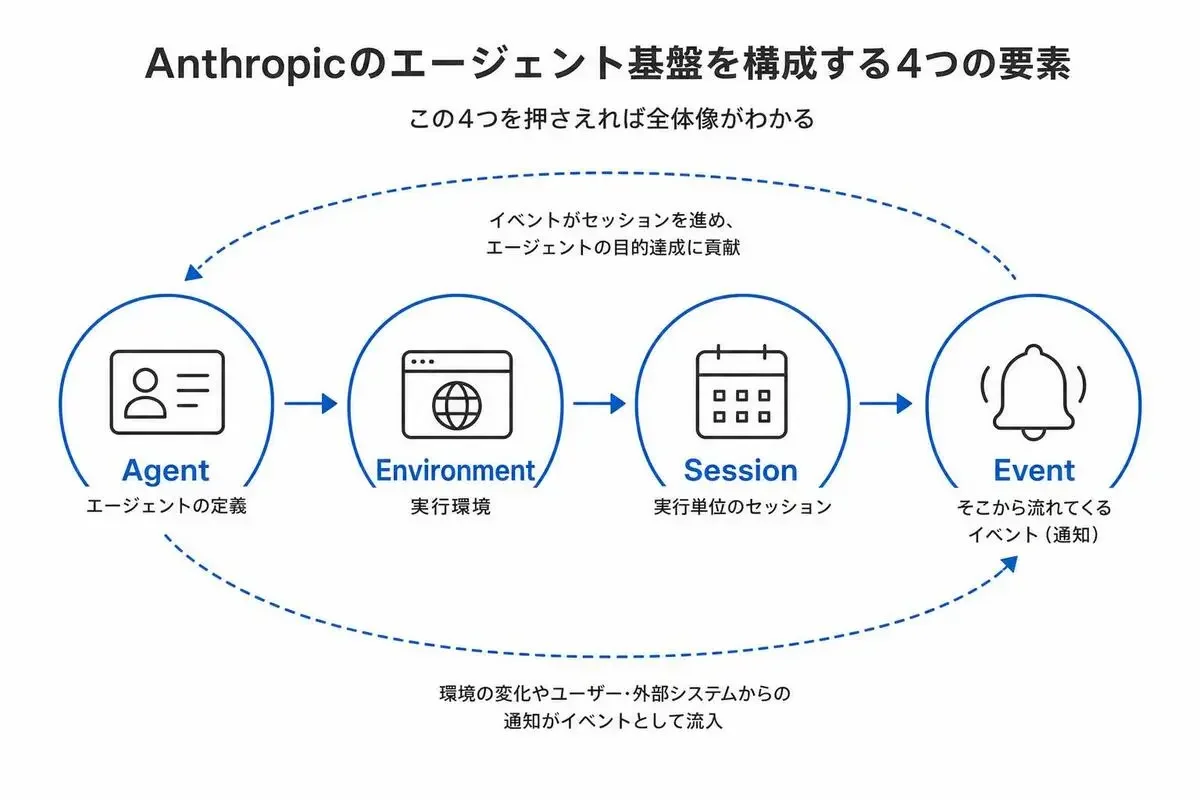
構成要素は Agent / Environment / Session / Event の4つです。
エージェントの定義、実行環境、実行単位のセッション、そこから流れてくるイベント。
この4語を押さえれば公式ドキュメントは読めます。
サンドボックスには bash / read / write / edit / glob / grep / web_fetch / web_search が最初から入っていて、ここにカスタムツールとMCPサーバーを足せます。
最低限の読み書きと検索はすぐ使えて、そこに自分の武器を足していく形です。
この5か月で積み上がったのが、セルフホストのサンドボックス、マルチエージェント編成、スケジュール実行です。
「常駐」と聞くと24時間課金され続けるのではと身構えるかもしれませんが、そうではありません。
サンドボックス、セッション、ファイルストレージ、認証情報がAnthropic側に置きっぱなしになる、という意味です。
Claude Codeとの違いは、動かす人が自分かどうかです
Claude CodeもAgent SDKも、自分のマシンで自分が動かします。
Managed Agentsは、Claudeの作業能力を自分以外の人やシステムに渡すための入れ物です。
自前ホストとの差はホスティングの主体そのもので、サンドボックス、セッション管理、ファイルストレージ、認証をまとめてAnthropicが持ちます。
自分で立てるサーバーがゼロになる代わりに、預ける範囲は広くなります。
つまり、サーバー管理から解放される分だけ、コントロールも手放す取引です。
Claude Managed Agentsは、自前で回していた人の面倒をどこまで解決したのか
自前でエージェントのループを書いていると、モデルを呼ぶ部分より周りの足回りに時間を取られます。
その足回りが公式側でどこまで埋まったかを並べると、こうなります。
表の右側、心当たりのある項目が並んでいるはずです。
埋まっているのは新機能ではなく、運用の足回りです。
時間を食うのはエージェント本体のロジックではなく、セッションが落ちたときの復帰や認証情報の受け渡しでした。
そこが丸ごとAPI側に寄っています。
Anthropicの内部テストでは、構造化ファイルを生成するタスクの成功率が10ポイントほど上がったとされています。
永続ファイルシステムの上で作業を分割できるためだと考えられます。
ステートレスな自前ループでは出しにくい差です。
数字だけだと実感しづらいかもしれませんが、大量のタスクを流し続ける運用ほど、この10ポイントは効いてきます。
ただし、足回りを預けるほど、預ける範囲そのものは広がります。
何を渡しているのか、外部接続とデータの残り方を見ていくと具体的に見えてきます。
MCPサーバーは接続できます、ただし認証情報の渡し方が2段階です
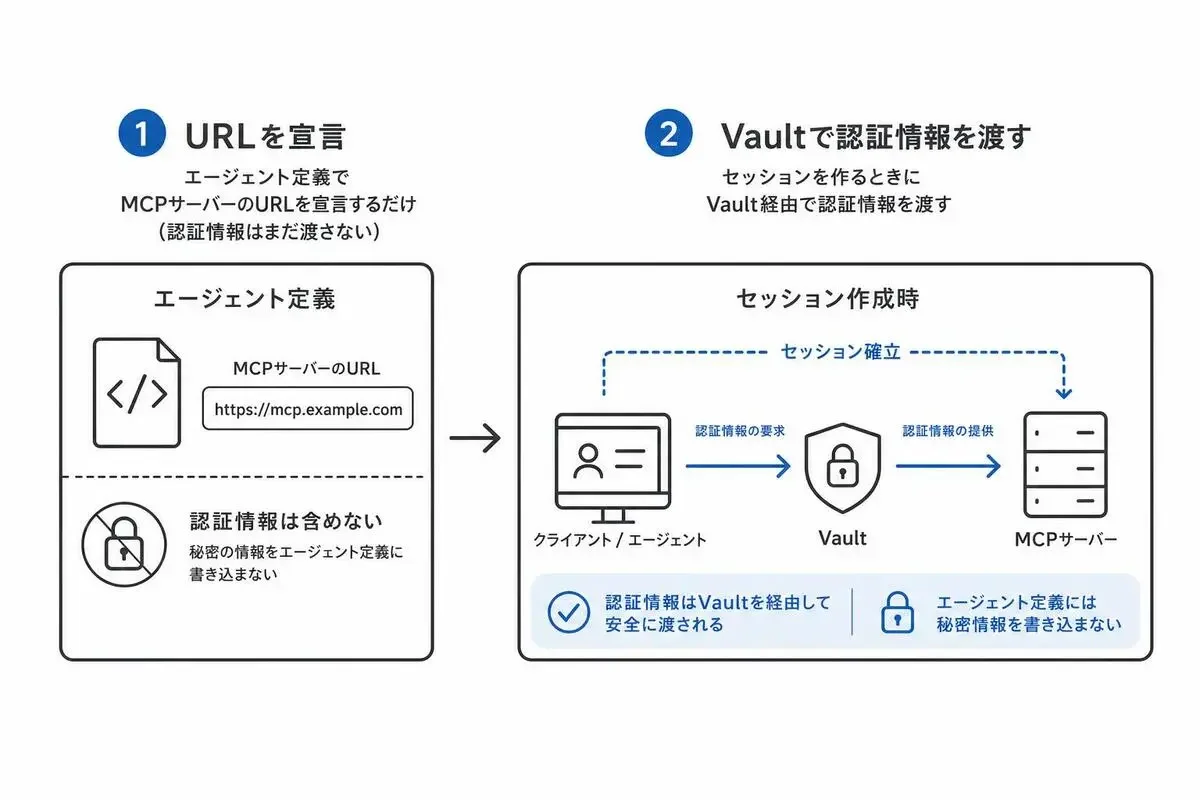
接続できるのはURLで叩けるリモートMCPサーバーだけで、1エージェントあたり20サーバーまで登録できます。
設計は2段階に分かれています。
エージェント定義の側ではMCPサーバーのURLを宣言するだけで、実際の認証情報はセッションを作るときにVault経由で渡します。
いわば、行き先だけ先に決めておいて、鍵は現地に着いてから渡すような作りです。
エージェント定義そのものにトークンを書き込まない構造です。
デフォルトの権限ポリシーは always_ask なので、繋いだ瞬間に何でも呼べるわけでもありません。
「繋がる」ことと「使い放題になる」ことは、ここでは別の話です。
実務で一番引っかかるのは、ローカルのstdio型MCPが対象外という点です。
普段ローカルで動かしているMCPを、そのまま繋ぐことはできません。
セルフホストのサンドボックスを使う構成なら手はありますが、素のManaged Agentsに繋ぐ前提で設計していると、ここで作り直しになります。
GoogleのAPIが403になるのは、サンドボックスのTLS検査が原因です
冒頭の403に戻ります。
原因を追うと、犯人はコード側ではありませんでした。
Anthropicのサンドボックスは、外に出る通信を「Anthropic sandbox-egress-production TLS Inspection CA」で中間者検査しています。
googleapis.comのAPIサーバーがこの証明書を拒否するため、403が返ります。
ネットワーク設定を緩めれば直りそうに見えます。
ですが、networking を unrestricted にしても、結果は同じでした。
私が踏んだ範囲で影響が出たのは、Gemini APIを含むGoogle系だけです。
Microsoftのedge-tts、httpbin.org、Pexels APIでは起きませんでした。
回避策は2つあります。
カスタムツールを定義してサンドボックスの外から叩くか、MCPサーバーを立ててプロキシするか。
直前のMCPの仕組みがそのまま逃げ道になります。
機密データの扱いは、ゼロデータ保持もHIPAAも現状は対象外です
医療や金融、個人情報を含む業務データを流す予定があるなら、ここで一度止まります。
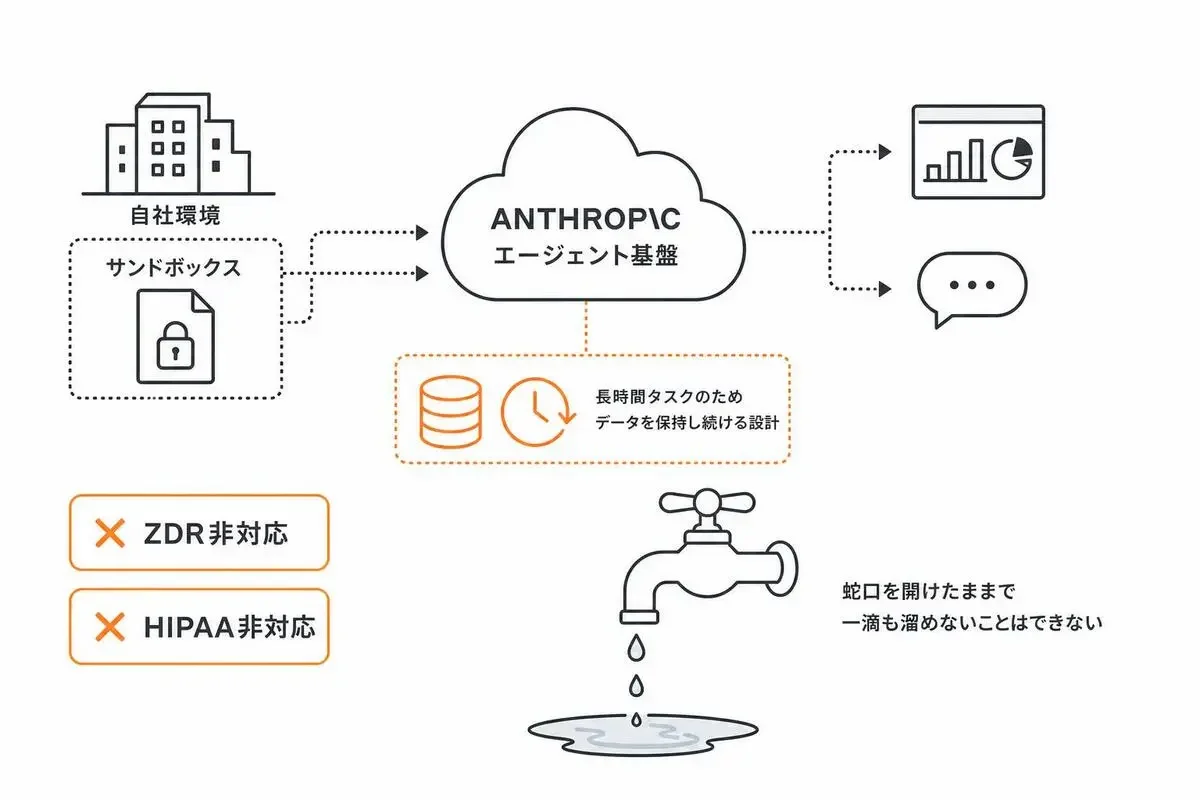
Managed Agentsは現状、ゼロデータ保持(ZDR)の対象外です。
HIPAAの事業提携者契約(BAA)の対象にもなっていません。
理由が運用ポリシーではなく設計そのものに紐づいていて、セキュリティ上の要件だけでは動かせないところが、この話の厄介な部分です。
セッションはステートフルで、会話履歴もサンドボックスの状態も生成物もサーバー側に永続化されます。
この作りだと「保持しない」が原理的に成立しません。
長時間のタスクを中断せず続けられること。
データを持たないこと。
この2つは、そもそも両立しない要求です。
蛇口を開けたまま、水を一滴も溜めるなと言っているようなものです。
消す手段は用意されています。
セッション削除のAPIと、ファイル単位の削除。
ただしどちらも明示的に呼ばない限り残ります。
デフォルトが「残る」側に倒れている前提で設計する必要があります。
ここで自社インフラに寄せれば解決するのでは、と思った人がいるはずです。
そこにも線引きがあります。
セルフホストサンドボックスにしても、ツールの入出力はAnthropicを通ります
Cloudflare、Daytona、Modal、Vercelなど10社以上、あるいは自前のサンドボックスクライアントAPIを使えば、ファイルシステムもプロセスもネットワークも自社インフラ側に残せます。
ここまでは想像通りです。
ただし、モデルが次に何をするか判断するために、ツールの入出力そのものはAnthropicの管制面を通ります。
実行環境を持ち帰っても完全な閉域にはなりません。
セルフホストにすれば安全、という早合点はここで潰れます。
料金はセッション1時間あたり約13円と、トークン代の合算です
「常駐」の意味は、すでに触れた通りです。
課金対象は running 状態の時間だけで、エージェントが待機しているあいだは課金されません。
セッションランタイムの単価は1時間あたり約13円(0.08ドル)で、ミリ秒単位で計測されます。
ここに標準のモデル別トークン単価が乗ります。
ここまではよくある従量課金の型です。
Batch APIの割引は適用されません。
Web検索を使うと1回あたり約1.6円(0.01ドル)が別途上乗せされます。
公式が出している計算例を円に直すと、こうなります。
Opus 5で1時間動かし、入力5万トークンと出力1.5万トークンを使った場合で合計約111円(0.705ドル)。
111円は、コンビニの缶コーヒー1本にも届きません。
入力のうち4万トークンをキャッシュ読み込みに回すと、約83円(0.525ドル)まで下がります。
Haiku 4.5でサポートチケットを1万件処理する例なら、約5,850円(37ドル)です。
1件あたりにすると、1円もかかりません。
常駐と聞いて身構えた人には拍子抜けする金額だと思います。
効いてくるのはランタイムよりトークン代の方で、1時間13円を気にするよりキャッシュを効かせた方が請求額に響きます。
ユースケースは、Notionや楽天の事例より手前から始めた方がいいです
ローンチパートナーとしてNotion、楽天、Asana、Sentryなどの名前が挙がっています。
公式が示す使い道も、長時間実行タスク、人の承認を挟む非同期ワークフロー、スケジュール実行、コード修正とPR作成、カスタマーサポートの自動化と幅広いです。
ただ、この規模の事例をそのまま自分の環境に持ってくるのは難しいです。
個人や小さいチームで検証するなら、もっと手前から始めた方がいいです。
むずかしく考えなくて大丈夫です。
私が試すならこの2つです。
- 週次のスケジュール実行で依存パッケージの更新PRを集めて、テストが通ったものだけを候補としてまとめる
- 障害チケットが立ったらログを読んで、再現手順を書き起こすところまでをエージェントにやらせる
選ぶ基準は2つで足ります。
失敗しても取り返しがつくこと。
人間の承認を挟めること。
この2条件を満たす仕事から渡せば、エージェントが暴走しても被害が有限で済みます。
Claude Managed Agentsを検討するなら、見る順番は料金表が最後です
この順番で潰していくのが、遠回りせずに済みます。
- 機密データを扱う予定があるか。あるならZDRとHIPAAが対象外の時点で今は止まります
- 繋ぎたいMCPがリモート型か。ローカルのstdio型しかないなら設計から変わります
- 外に出る通信の相手がTLS検査を通るか。ここで詰まると回避策の実装コストが乗ります
- そのうえで料金を見る
1時間13円という数字は、上の3つが通った人にだけ意味を持ちます。
ベータのまま5か月動いている基盤なので仕様はまだ動きますが、預ける範囲と預けない範囲の線は、今の時点でかなりはっきり引かれています。
まずは1番だけ潰してみてください。
そこで止まらなければ、試す価値はあります。
- 5
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
AI脱社畜
- 3
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 5
- 1
-
- 5
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
 弾丸旅プラン@りの
- 7
- 0
-
AI経営者の参謀@ひで
- 4
- 0
-
 NONOKA
- 5
- 0
-
- 5
- 0
-
 gen
- 1
- 0
-
ワンオペ育児×AI@まな
- 2
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます