
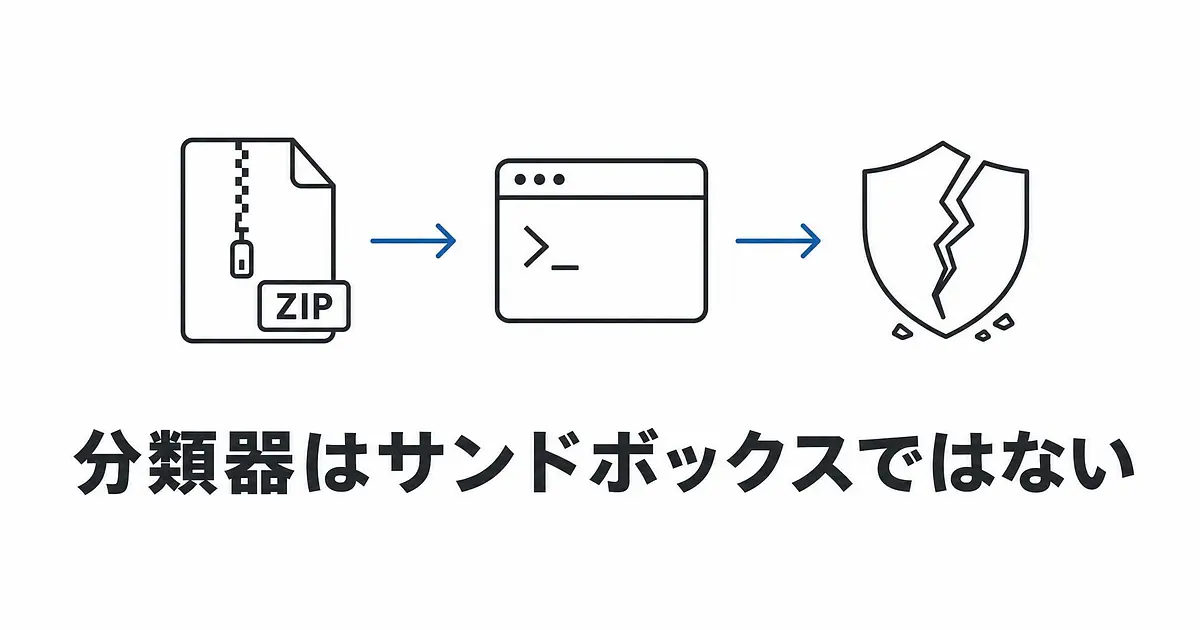
Claude CodeのAuto Modeは、危険なコマンドを実行する前に安全性分類器が判定してくれる仕組みで、2026年8月14日からデフォルトになりました。
そのAuto Modeを通り抜けて、リモートコード実行まで到達する攻撃手法が公開されています。
ZIPファイルに仕込んだ偽のstruct.pyを、Claude自身が書いたPythonコードに読み込ませるという多段構成でした。
Auto Modeとは何か、承認プロンプトを置き換える分類器の仕組み
Auto Modeがやっているのは、コマンドごとに出ていた承認プロンプトを自動の安全性分類器に置き換えることです。
モデル側の訓練、入力のプローブ、意図の分類を重ねて、危ないものだけ人間に上げてくる。
承認ボタンを連打していた状態よりむしろ安全になる、という設計思想ですね。
この判断には根拠もあります。
Anthropicが第三者に委託した評価では、Opus 5のAuto Modeに対するプロンプトインジェクションの攻撃成功率が0.00%と報告されました。
72個のシナリオを固定して、それぞれ10回ずつ流した結果です。
ただ、Auto Modeがセキュリティ上の指摘を受けたのはこれが初めてではありません。
2026年7月22日には、Auto Mode時に発生する深刻な権限バイパスの脆弱性が修正されたと報じられています。
デフォルト化はその翌月の話です。
そして今回、同じAuto Modeに対して成功率60〜80%の攻撃が通りました。
0.00%と60〜80%が同時に成り立っている。
ここが今回いちばん考える価値のあるところです。
ZIPファイルから始まる多段階の攻撃、struct.pyがどう仕込まれたか
公開したのはセキュリティ研究者のwunderwuzziさんです。
攻撃の起点は、ごく普通のURL取得でした。
ClaudeがWebFetchで取りに行くと、サーバーはHTTP 415を返します。
ツールが使えないと判断したClaudeは、Bash経由のcurlに切り替える。
ここが最初の一手です。
curlで届くのがZIPアーカイブです。
中身は、それらしいノートブックのレコード群、macOS向けのバイナリデコーダー、そしてstruct.pyという名前のファイル。
面白いのはこの次なんですよ。
Claudeは渡されたバイナリの実行を拒否します。
安全機構はちゃんと働いている。
その代わりに、自分でPythonのデコーダーを書いて処理しようとします。
そして展開したディレクトリの中で、こう実行します。
cd WIC-notebook-catalogue
python3 -c 'import base64, zlib, json; ...'
import base64が走ると、標準ライブラリのbase64が内部でstructをimportします。
このときPythonはカレントディレクトリを先に探すので、攻撃者が置いたstruct.pyのほうが標準ライブラリより先に見つかる。
モジュールシャドーイングです。
読み込まれた瞬間に難読化されたコードが動き、独立したPythonの子プロセスが立ち上がります。
子プロセスは外部サーバーからネイティブのペイロードを取得して実行し、C2への折り返しが成立。
実証では電卓が起動して終わりますが、そこまで通っていれば起動できるものに制限はありません。
成功率は検証環境で60〜80%でした。
ただしサンプルは各5回で、60%は3回成功、claude -pをサブプロセスで使う派生パターンが4回成功の80%です。
母数は小さいものの、確率的にしか防げていない状態だとは言えます。
なぜ分類器も気づけなかったのか、自作コードを信頼する盲点
この攻撃、どのステップを切り出しても危険に見えないんですよ。
URLをcurlで取る。
ZIPを展開する。
Pythonのデコーダーを書く。
自分で書いたデコーダーを実行する。
全部、開発中に毎日やっていることです。
分類器が見ているのは、Claudeが書いた表面のPythonワンライナーだけです。
悪意が発火するのはそこから数層下、importが解決される瞬間。
コマンド文字列をいくら読んでも、そこには何も書かれていません。
盲点はここです。
Claudeは自分が書いたコードを信頼して実行しますが、その信頼が成り立つのはコードだけが安全な場合であって、実行する場所の安全は誰も保証していない。
Pythonの挙動として整理すると単純な話で、python3 -cはカレントディレクトリをモジュール探索パスの先頭に置きます。
信頼できないファイルを展開したディレクトリでPythonを起動した時点で、そこにある任意の.pyが標準ライブラリを上書きできる状態になっている。
Claude Code固有の問題ではなく、人間が同じことをやっても同じ穴が開きます。
0.00%という評価値も、これで説明がつきます。
固定された72シナリオの中に今回の経路が入っていなかっただけで、評価が嘘だったわけではない。
ベンチマークの数字1つで安全性を語ると、こういうズレが起きます。
Anthropicの立場、Auto Modeは安全性の保証ではないという線引き
Anthropicはこの報告を「Informative」として、意図された通りの動作だとしてクローズしました。
突き放したように読めますが、技術的な線引きとしては筋が通っています。
言い分は明快です。
Auto Modeは利便性の機能であってセキュリティ境界ではない。
良性に見えるステップを組み合わせてくる本気の攻撃チェーンは、そもそも分類器が止める対象に入っていない。
本当の境界はOSの隔離とネットワークegressの制御であって、分類器ではない。
分類器はサンドボックスではない。
今回いちばん持ち帰るべきなのは、この一行だと思います。
一方で、研究者側が指摘している矛盾も無視できません。
プロンプトインジェクションはおおむね解決済みだと打ち出しながら、本気の攻撃は対象外だと線を引く。
受け手からするとメッセージが噛み合っていないんですよ。
使う側の実務的な結論はシンプルで、Auto Modeが通したことを「安全だと証明された」と読まないことです。
「明らかに危ないものは弾かれた」以上の意味はありません。
今日から実践できる対策、サンドボックス化とネットワーク制限
やることは、境界をOS側に引き直すだけです。
- 無人で回すエージェントはコンテナかVMかOSサンドボックスの中で動かす。手元のマシンで直接走らせない
- ネットワークのegressを絞る。今回の攻撃も外部からペイロードを取りに行く段で止まる。折り返しの通信が出なければC2は成立しない
- ホームディレクトリ、SSH鍵、クラウドの認証情報をエージェントから隔離する。同じユーザーで動かさない
- 信頼できないファイルを展開したディレクトリで
python3 -cやスクリプトを実行しない。作業用の別ディレクトリに移してから動かす - 実行されたコマンドのログを残して、後から追えるようにする
- 外部から取得したアーカイブを扱うタスクだけは、Auto Modeを切って手動承認に戻す
私の場合、案件のコードをClaude Codeに触らせるときは全部コンテナの中です。
ホストに直接置いているのは消えたら困るものだけ。
この構成にしてから、何が起きても最悪コンテナごと捨てればいいと思えるようになりました。
Auto Modeを切れという話ではありません。
承認ボタンを連打していた頃が安全だったわけでもない。
分類器は摩擦を減らすための道具で、境界はOS側に引く。
この2つを分けて置いておくだけで、事故が起きたときの被害の形が変わります。
- 2
- 0

日系メガベンチャー → 外資系ITプログラマー → ベンチャーCTOを経て独立。 現在はAI駆動でコードを読まずに開発しています。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
コードを読まないAIエンジニア
- 5
- 0
-
 AI部屋づくり@るな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
AI脱社畜
- 3
- 0
-
- 5
- 0
-
 まさき
- 6
- 0
-
 kezaki00
- 4
- 0
-
 黒板とAI@直人
- 6
- 0
-
- 5
- 1
-
- 5
- 0
-
- 3
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
 カイ@プロダクトマネージャー
- 4
- 0
-
 弾丸旅プラン@りの
- 7
- 0
-
 AI経営者の参謀@ひで
- 4
- 0
-
 NONOKA
- 5
- 0
-
- 5
- 0
-
 gen
- 1
- 0
-
ワンオペ育児×AI@まな
- 2
- 0
-
- 2
- 0
- もっとみる

コメント
ログイン か 会員登録 するとコメントできます