
英語で話し始めて、単語が出てこなくて、言い直そうと息を吸った瞬間に相手が喋り出す。
これ、人間の先生相手より気まずいんです。相手はAIなので、こちらが黙った理由を汲んでくれるわけではありません。
沈黙を埋めるのが上手くなった音声モデルに、あえて黙っていてもらう。そのための指示の書き方の話をします。
言い直す前に、なぜ食い気味に返ってくるのか。
AI英会話で詰まったとき、こんな流れになったことはないでしょうか。
I went to... えっと、過去形これでよかったっけ、と考えている0.5秒のあいだに、相手が「mhmm」と相槌を入れてくる。そこで気が散って、結局言いかけた文を最後まで組み立てられずに終わる。
少し前まで、AIとの音声会話の不満は正反対でした。こちらが話し終わってから返事が来るまでが長い、間が死んでいる、という不満です。だから沈黙が減ったこと自体は、会話練習にとって明確な前進でした。
厄介なのは、初中級者にとっての沈黙が「発話の終わり」ではないことです。文法を組み立て直している時間であり、単語を探している時間であり、言い直しを始める助走の時間でもあります。
ここを終わりと読まれると、練習が「話しきる練習」ではなく「詰まったところで話を引き取られる練習」になってしまいます。
沈黙が消えた会話の仕組み
2026年7月8日、OpenAIがChatGPTの音声会話を担う新世代モデルとしてGPT-Liveを発表しました。
一番の変化は全二重(full-duplex)になったことです。従来は片方が話し終わるのを待ってから処理するターン制でしたが、GPT-Liveは入力を処理しながら同時に自分の音声を生成します。その結果、1秒間に何度も「話すか、聞き続けるか、黙るか、割り込むか」を判断し続ける設計になっています。
会話の進行そのものはこのモデルが担当し、検索や踏み込んだ推論は裏側の別のモデル(発表時点ではGPT-5.5)に委ねる2層構成になっているのも特徴です。だから考え込んでいるあいだも会話が途切れません。
提供プランは、Go/Plus/Proが GPT-Live-1、無料ユーザーが GPT-Live-1 mini というかたちで分かれています。応答の深さも Instant Medium High から選べるようになりました。
では、黙って待たせることはできないのでしょうか。できます。OpenAIが挙げている自然さの例には、相槌を打つことと、ユーザーが考え込んでいるあいだは黙って待つことの両方が入っています。
問題は、待つか喋るかを決めるのがモデル側だということです。考えがまとまらずに空いた間と、話し終わって空いた間を、モデルは外側の音からしか判断できません。だから、こちらの沈黙が何を意味するのかを先に教えておく必要があります。
待ってもらう指示は、どう書くか。
やることは、沈黙の意味を先に定義しておくことです。私が使っている指示は、次の3つの軸で組み立てています。
- 無音の扱いを決める。こちらの沈黙は「終わった」ではなく「考えている」だと宣言する
- 相槌を止める。こちらが話しているあいだの
mhmmやyeahを抑えてもらう - 言い直しを完成させない。文の途中で止まって言い直したら、最後まで言わせてもらう
英語でそのまま渡すなら、この程度の短さで十分です。
I'm practicing English, so please follow these rules.

1. When I go silent, I'm thinking, not finished. Stay quiet and wait.
2. Don't use backchannels like "mhmm" or "yeah" while I'm speaking.
3. If I stop mid-sentence and start over, let me finish my own sentence. Never complete it for me.
待ち時間を具体的に指定すると、指示の意図がさらにはっきりします。
Wait at least five seconds of silence before you respond.
If I still say nothing after that, just ask "take your time?" and wait again.
ここは正直に書いておきます。これは秒数を固定する設定ではなく、あくまでモデルへのお願いです。判断は1秒間に何度も更新されているので、指定より早く返事が来ることは起こります。
それでも書いておく価値があるのは、待ってほしいと伝えたかどうかで、言い直しきるまでの猶予が変わるからです。何も言わなければ、モデルは普通に会話を進める相手として振る舞います。
毎回これを打ち込むんですか、と思いますよね。練習用のプロジェクトに指示を保存しておくか、会話の冒頭で「I'm practicing. Let me lead.」の1行だけ言ってから始めれば済みます。
専用アプリと汎用モデル、練習相手としての違い
じゃあ英会話アプリではなく汎用モデルで練習すべきなのか、というと、そういう単純な話でもありません。

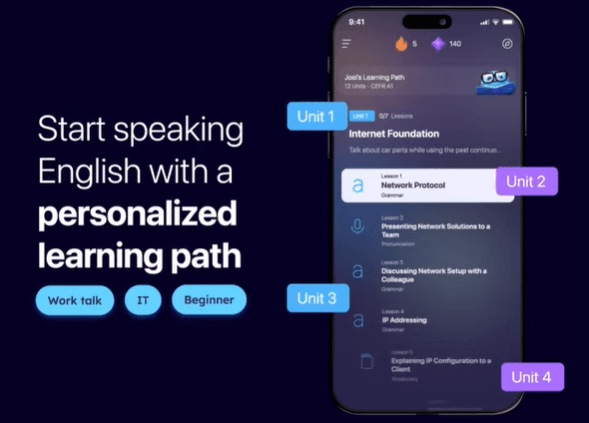
Speakのようなスピーキング特化アプリは、場面別のレッスン設計とフィードバックの型が作り込まれています。ELSA Speakなら発音の採点という独自の物差しがあります。どちらも「今日何を練習するか」を決めてくれるので、教材を自分で用意しなくていい。
汎用モデル側の強みは別のところにあります。練習相手の挙動そのものを、こちらの言葉で書き換えられることです。待ってほしい、遮らないでほしい、返事は3文以内にしてほしい。この手の要求を出せる相手は、じつはそんなに多くありません。
自分の詰まり方が分かっている人ほど、後者が効きます。逆に、まだ何が苦手か言語化できていない段階なら、型のあるアプリから入ったほうが迷いません。
待ってもらう設計が、話す勇気になる
2026年9月10日には、GPT-Live-1 が開発者向けにAPIでも提供されました。音声のフロントエンド層が1分あたり0.05ドル(約8円)で、推論を担う裏側のモデルやツールの料金は別途かかります。英会話アプリ側がこの世代の音声を取り込んでくるのは、そう遠くない話です。
そうなったとき、遮られない練習環境は勝手には手に入りません。沈黙を埋める技術が上がるほど、学習者側が「ここは待ってほしい」と設計する側に回る必要が出てきます。
そしてこれ、AI相手だけの話ではないんです。会議で言い淀んだときに「ちょっと待ってください」と言えるかどうかは、英語力とは別に手放したくない技術でした。
まずは次の練習で、会話の1行目に「Wait for me when I pause.」と入れてみてください。それだけで、言いかけた文を最後まで言いきれる回数が変わります。
- 5
- 0
英語学習・資格試験に励む社会人。DeepLやAI英会話、シャドーイング教材づくりなど、AIを使った語学学習のコツを日々発信します。
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
 nana
- 5
- 0
-
 みほ
- 5
- 0
-
 ここな
- 5
- 0
-
プロンプト画伯
- 5
- 0
-
AI脱社畜
- 3
- 0
-
 まさき
- 6
- 0
-
コードを読まないAIエンジニア
- 5
- 1
-
- 3
- 0
-
 さくら
- 4
- 0
-
 ワンオペ育児×AI@まな
- 5
- 0
-
nana
- 3
- 0
-
- 3
- 0
-
- 5
- 0
-
- 5
- 0
-
nana
- 3
- 0
-
 えま
- 4
- 0
-
 キャリア迷子@そら
- 2
- 0
-
クロージング師匠
- 1
- 0
-
えま
- 5
- 0
-
さくら
- 4
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます