
「AIにアプリを作らせる」といえば、これまではAIにコードを書かせることでした。
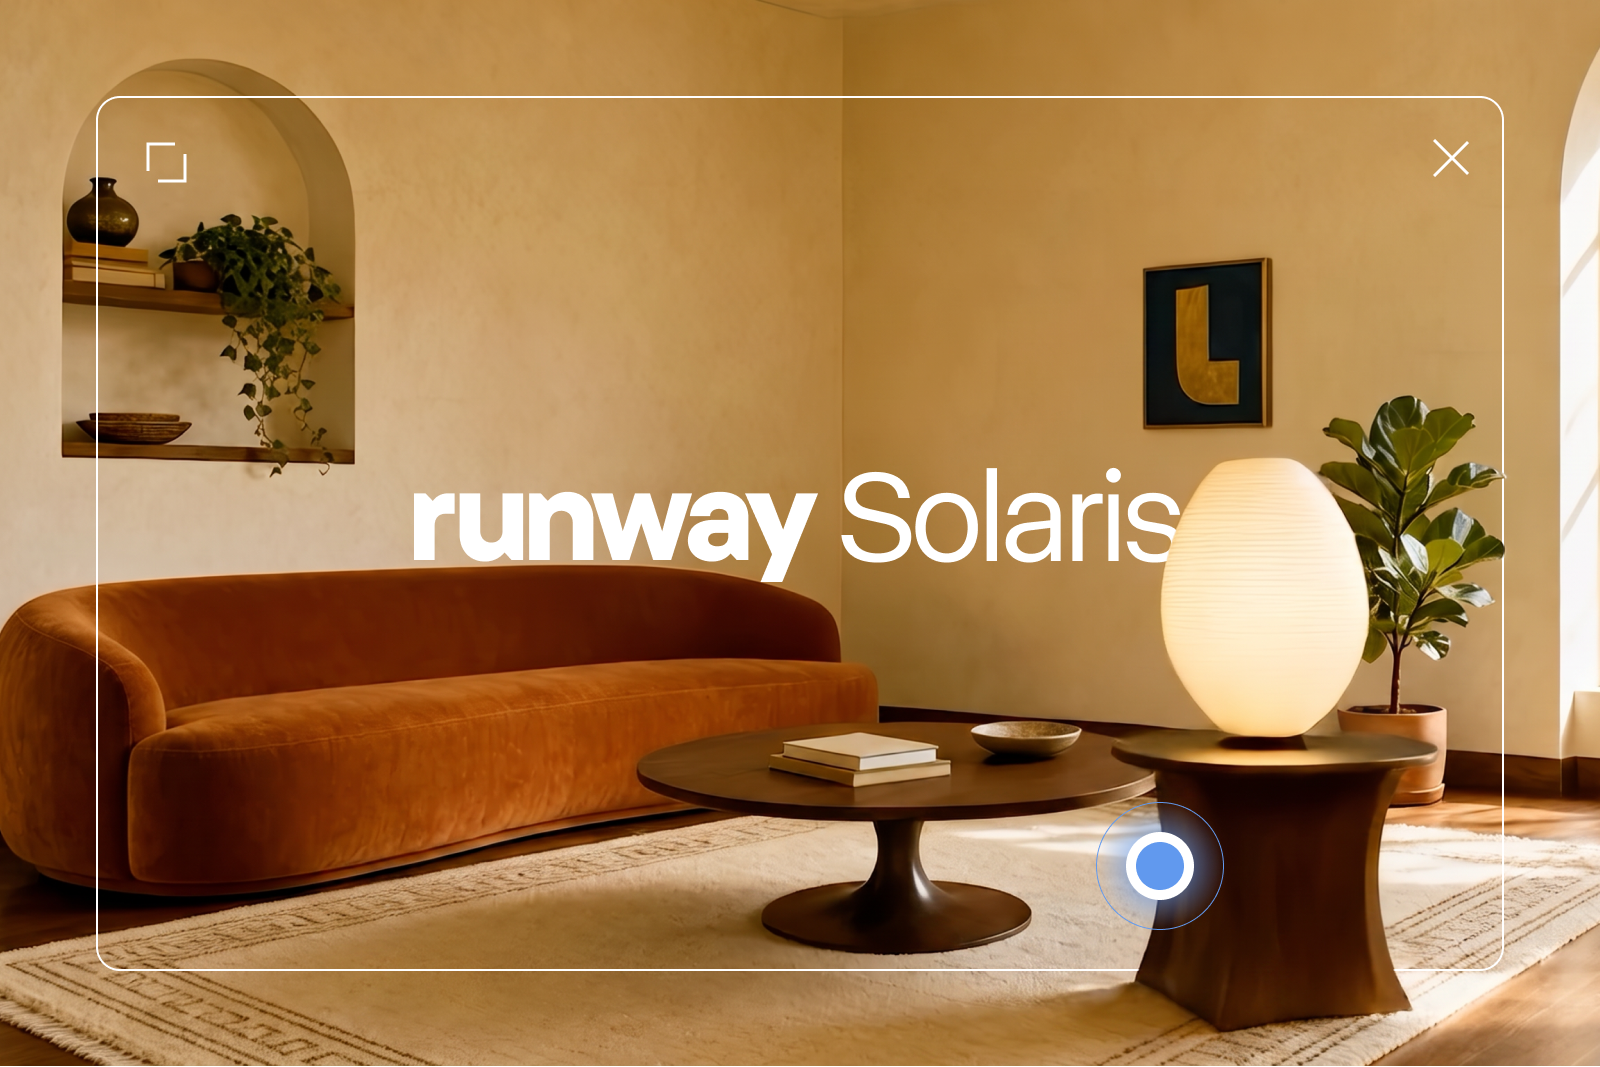
Runwayが2026年8月31日に発表した「Runway Solaris」は、その前提をまるごと外してきています。
コードを1行も生成せず、画面そのものを1フレームずつ絵として描き続けるモデルなんです。
アプリではなく、今の一瞬をフレームで描いている
Runwayが「Interface World Model」と名付けた新しいモデルファミリー。
その第1弾がSolarisです。
直訳すると「インターフェースの世界モデル」で、名前だけだとピンと来ないと思うんですが、やっていることはかなり単純です。
画面を、1フレームずつ絵として生成している。
ほぼこれだけ。
普通のWebアプリなら、HTMLとCSSとJavaScriptがあって、ブラウザがそれを解釈して画面を描きます。
Runway Solarisにはこの中間層がありません。
クリックした、ドラッグした、テキストで指示した。
その入力を受けて「次の1フレームはこう見えるはずだ」という絵をその場で生成する。
それを繰り返すことで、動いているアプリのように見せています。
ベースになっているのは、Runwayの動画生成モデルGen-4.5。
解像度は720pで、事前に用意された画面もテンプレートも存在しません。
画像生成AIを日常的に触っている人ほど、この構造は腹落ちしやすいはずです。
ユーザーの操作を条件付け(conditioning)として食わせながら、img2imgを延々と回し続けている。
そう思ってもらえれば、だいたい合っています。
ここまでだと「それってv0みたいなやつでしょ」と思うかもしれません。
そこが一番の誤解ポイントなんです。
コードを生成するAIとは、そもそも仕組みが違う
v0やBolt.newのような、話しかけるだけでReactのコードを吐いて、そのまま動くアプリにしてくれるツール。
あれとRunway Solarisは、できることが似ているだけで根っこがまったく違います。
コード生成型は、AIが働くのは「作る」瞬間だけです。
一度コードができてしまえば、あとはブラウザが決められた通りに動かす。
同じボタンを100回押せば、100回同じ結果が返ってきます。
Runway Solarisは違います。
動いている間ずっと、モデルが次のフレームを生成し続けている。
アプリが「存在している」のではなく、見ている間だけ「生成され続けている」状態です。
だからRunway Solarisには、保存できる成果物がありません。
コードがないので、GitHubに上げることもデプロイすることもできない。
あるのは、そのとき生成された映像だけです。
見た目が生きて動く、という3つの技術的な裏付け
動画生成モデルは普通、1本作るのに何十秒も待たされます。
それを人の操作に追従する速度まで持っていくために、Runwayは3つの手を打っています。
- 自己回帰でフレームを描く。各フレームは「それより前に何があったか」だけを見て生成されます。先の展開を持たないまま前へ進む設計なので、操作をその場で受け止められる
- ノイズ除去のステップを数回まで圧縮する。多段のデノイズ処理を数ステップまで蒸留した、と公式は書いています。画像生成でいうTurbo系・LCM系のステップ削減と同じ発想です
- 自分の出力で自分を訓練する。速くしたモデルを、そのモデル自身が出した映像で再訓練しています。画像をimg2imgに何度も通すと少しずつ崩れていく、あの劣化を抑えるための工夫です
2番目の蒸留が効いていて、標準的な動画拡散モデルと比べて桁違いに安く動くとされています。
リアルタイム化とコスト削減が同じ工夫から出てきているのが、うまいところです。
そしてRunway Solarisは、単体で動いているわけではありません。
言語モデルが「次にこの画面はどう変わるべきか」を判断し、世界モデルが「それがどう見えるか」を描く。
何をするか決める係と、それがどう見えるかを作る係。
推論と描画がきれいに分かれているんです。
試着も家具の色変えも、同じ仕組みで動いている
服をドラッグして人に重ねると、その人が着た状態がそのまま生成される。
Runwayが挙げているユースケースの1つがこれです。
並んでいる例が、なかなか振り幅があります。
- バーチャル試着。服を操作するだけで着せ替えが成立する
- 物理の授業。燃焼のデモを、対話しながらその場で動かす
- 家具のビジュアライズ。指示を出して色や配置を変える
- AIエージェントの訓練環境。変化し続ける環境をいくらでも用意できる
- 客ごとに姿を変えるストアフロント
- 学習者に合わせて中身が変わるチュートリアル
従来ならこれ、全部が別々のプロダクトです。
試着アプリ、物理シミュレータ、インテリアシミュレータ、強化学習環境。
それぞれに開発チームがいて、それぞれにコードベースがある。
Runway Solarisはこれを、1つのモデルで全部やっています。
用途ごとにアプリを作っているのではなく、「今この人が見るべき画面」をその都度描いているだけだから、用途が変わっても仕組みは変わらない。
個人的にはここが一番アツいところで、「アプリを作る」という工程そのものが要らなくなる可能性がある、という話なんです。
今はまだ、ウェイトリストの向こう側にある
Runway自身が、弱点をかなり率直に認めています。
最大の課題は文字です。
安定して読める文字を出すのが、いまだに最も難しい問題のまま。
画像生成AIで看板やロゴの文字を書かせると崩れるやつ、あれと同じ問題です。
ただしインターフェースは意味の大半を文字に預けているぶん、影響はもっと深刻になります。
もう1つがハルシネーション。
もっともらしく見える間違った結果は、何も出ないより悪い場合がある。
Runwayはそう指摘しています。
ボタンの位置が毎回変わる、押したら存在しない画面に飛ぶ。
コードなら仕様として担保できることが、生成モデルでは保証しきれません。
長いセッションでの一貫性も研究途上で、スクリーンリーダーなどの支援技術にはまだ対応していないと明言されています。
そして提供状況も、今はウェイトリスト制の早期アクセス段階。
パートナー企業と組んで一般公開に向かっている、というアナウンスにとどまっています。
明日から仕事で使えるツールではありません。
まとめ 次にプロンプトを書く相手は画面そのものになる
Runway Solarisが面白いのは、機能そのものより「プロンプトの宛先が変わる」ところです。
これまでは、モデルに向かって「こういう絵を描いて」と言っていました。
Runway Solarisでは、目の前で動いている画面に向かって「こうなって」と言う。
相手が静止した1枚から、反応してくる画面に変わるわけです。
そうなると効いてくるのは、結局また言語化です。
画面に何をしてほしいのか、どういう状態になってほしいのかを、言葉で正確に渡せるかどうか。
プロンプトを書くスキルの射程が、画像から画面まで伸びていくことになります。
ウェイトリストは公式ページから登録できます。
実際に触れる日が来たら、また試した結果を持ってきます。
- 2
- 0
元デザイナー → AI画像職人。絵心ゼロだったけどプロンプト極めたらなんとかなった。「センスじゃない、言語化だ」 使えるプロンプト&失敗例を晒していく
創刊メンバー募集 第1期・100名
AIの知見を、記事にして売る。
AimanaVoは実践者のAI活用ナレッジが集まる、書いて売れるメディアです。
販売手数料 標準13% 永続5%
他サービスとの併売OK・どなたでも応募できます
AimanaVoとは
こちらもおすすめ 自動 同じトピック・タグの記事から
-
プロンプト画伯
- 5
- 0
-
コードを読まないAIエンジニア
- 5
- 1
-
- 3
- 0
-
 さくら
- 4
- 0
-
 nana
- 3
- 0
-
- 3
- 0
-
- 5
- 0
-
nana
- 3
- 0
-
クロージング師匠
- 1
- 0
-
さくら
- 4
- 0
-
 ゆず
- 5
- 0
-
 このは
- 5
- 0
-
nana
- 5
- 0
-
ゆず
- 3
- 0
-
- 5
- 0
-
さくら
- 6
- 0
-
さくら
- 4
- 0
-
- 4
- 0
-
- 6
- 0
-
- 3
- 0
- もっとみる
コメント
ログイン か 会員登録 するとコメントできます